






مفارقة المعلومات العكسية...
هل أصبح الذكاء الاصطناعي يتعلم منك أكثر مما تتعلم منه؟

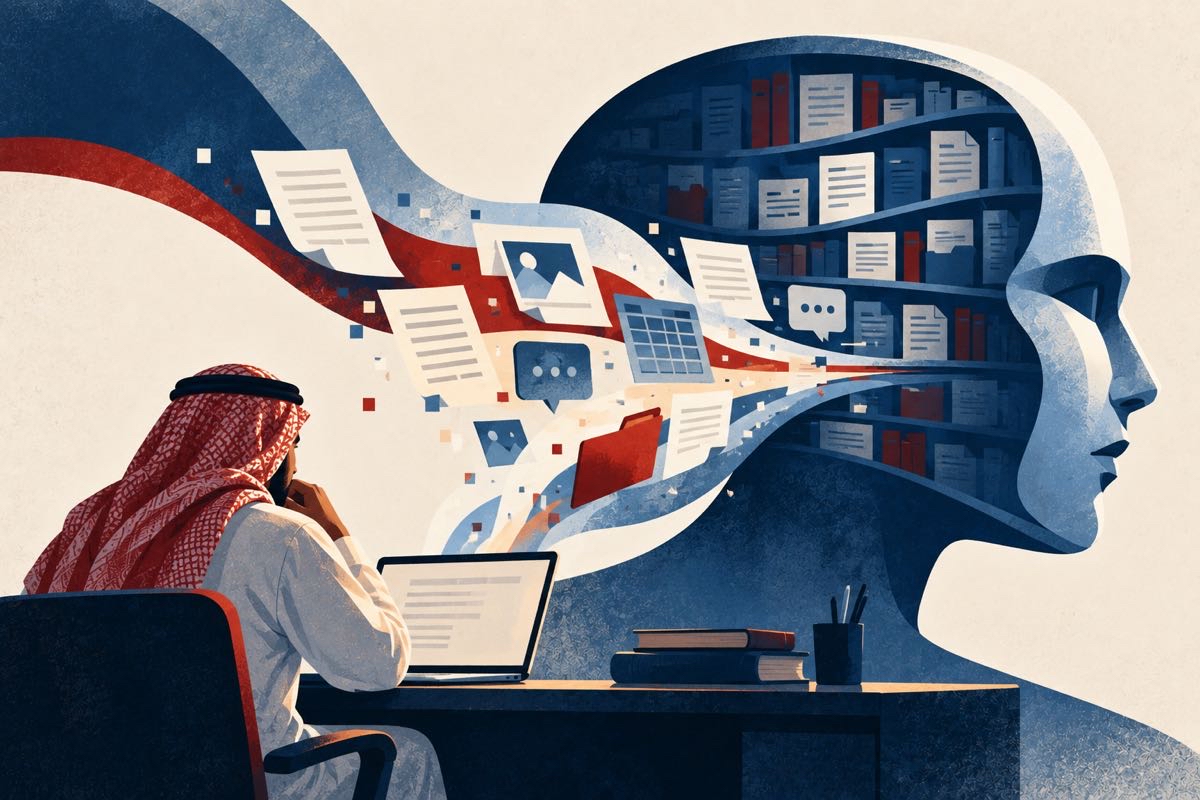
منذ فترة وأنا ألاحظ شيئاً يستحق التوقف عنده. الذكاء الاصطناعي لم يعد أداة نطلب منها إجابة ثم نمضي، بل صار شريكاً نتعامل معه يومياً في العمل والتعليم والإبداع.
وكلما ازداد حضوره في حياتنا، ازداد إلحاح سؤال بسيط: ما الذي ندفعه نحن فعلياً مقابل هذه الخدمة؟
الجواب المباشر هو الاشتراك الشهري أو السنوي. لكن هناك ثمن آخر، أقل وضوحاً وأكثر قيمة في الحقيقة، وهو المعرفة التي نقدمها نحن بأنفسنا للأداة.
يذكّرني هذا بمقولة قديمة تتردد كثيراً في عالم التقنية: ”إذا لم تكن تدفع ثمن المنتج، فأنت المنتج“. ولطالما فُهمت هذه العبارة في سياق منصات التواصل الاجتماعي وبيع بيانات المستخدمين للمعلنين. لكن مع الذكاء الاصطناعي التوليدي، الأمر يأخذ منحى مختلفاً تماماً، وأعمق مما تفسره هذه المقولة وحدها.
هناك مفهوم بدأ يتردد أخيراً بين الباحثين في الاقتصاد الرقمي، يُطلق عليه ”مفارقة المعلومات العكسية“ ”Reverse Information Paradox“. والاسم مستوحى من مفارقة اقتصادية أقدم بكثير، طرحها الاقتصادي الأمريكي كينيث أرو، الحائز على نوبل، سنة 1962.
فكرة أرو كانت بسيطة: إذا أردت بيع معلومة أو فكرة لشخص، فلا بد أن تكشفها له أولاً حتى يقتنع بشرائها. لكن بمجرد أن يطّلع عليها، يكون قد حصل عليها مجاناً، وقد لا يحتاج بعدها لدفع شيء. المخاطرة إذن كانت دائماً على البائع.
اليوم، الصورة انقلبت تماماً. المستخدم هو من يتحمل المخاطرة، لا الشركة. نحن نشترك في خدمة ذكاء اصطناعي عامة، ثم نبدأ بأنفسنا في ”تدريبها“ على احتياجاتنا: نرفع مستنداتنا، نشرح طريقة عملنا، نصحح أخطاءها، نضيف تفاصيل دقيقة تراكمت لدينا عبر سنوات. وكل ذلك لكي تصبح أكثر فائدة لنا تحديداً.
والسؤال الذي بقي عالقاً في ذهني بعد كل هذا: من غيرنا يستفيد من هذه المعرفة التي نقدمها؟
كل مرة نتفاعل فيها مع أداة ذكاء اصطناعي، نترك خلفنا أثراً. بعض الباحثين يسمونه ”العادم المعرفي“ ”Intelligence Exhaust“ - الأوامر التي نكتبها، الملفات التي نرفعها، التصحيحات التي نجريها، بل وحتى الطريقة التي نصف بها مشكلة معينة.
كل واحدة من هذه اللقطات وحدها قد تبدو تافهة لا تستحق الذكر. لكنها مجتمعة، ومع مرور الوقت، تكوّن صورة دقيقة عن أسلوب العمل، والخبرة المتراكمة، وربما المعرفة الضمنية التي تشكّل فعلياً الميزة التنافسية لشخص أو لمؤسسة كاملة. وهذا بالضبط ما يجعل شركات كبرى تنظر لهذه البيانات باعتبارها أصلاً معرفياً، لا يقل أهمية عن بياناتها المالية أو ملكيتها الفكرية.
بعض المختصين في هذا المجال يصفون ما يحدث بـ ”الدفع المزدوج“. فالمؤسسة تدفع اشتراكاً مالياً مقابل خدمة الذكاء الاصطناعي، وفي الوقت ذاته تقدّم لها خبرتها العملية وسياق أعمالها الداخلي، وهو ما قد يُستخدم - حسب سياسة كل مزوّد - في تحسين النماذج أو تطوير خدمات مستقبلية لن تكون بالضرورة حكراً عليها هي.
هنا يظهر تحدٍ حقيقي يتعلق بحوكمة البيانات، خصوصاً في القطاعات التي تعتمد على أسرار صناعية أو خبرات يصعب تعويضها لو تسربت أو استُغلت.
بعض الشركات بدأت تأخذ هذا الموضوع على محمل الجد. من الحلول المتّبعة اشتراط سياسة عدم الاحتفاظ بالبيانات أو استخدامها في التدريب ”Zero Data Retention“، وأخرى تفضّل تشغيل نماذج الذكاء الاصطناعي داخل بنيتها التقنية الخاصة بدل الاعتماد الكامل على خدمات سحابية عامة.
هناك أيضاً من يلجأ لطبقات وسيطة تُخفي الأسماء والبيانات الحساسة قبل إرسال أي طلب للنموذج، في محاولة لتحقيق توازن بين الاستفادة من الأداة وحماية ما هو حساس.
لست هنا لأدعو أحداً للتوقف عن استخدام الذكاء الاصطناعي؛ فهو أصبح جزءاً لا يمكن تجاهله من مستقبل العمل والاقتصاد. لكن ما أدعو إليه هو استخدام أكثر وعياً بما نقدّمه، لا بما نأخذه فقط.
الذكاء الاصطناعي يزداد ذكاءً بقدر ما نغذّيه به. أما المعرفة المتخصصة والخبرة التي بنيناها على مدى سنوات، فتبقى هي رأس المال الحقيقي، لنا نحن، لا للأداة.
وربما، في زحمة السباق نحو أفضل النماذج، السؤال الذي يستحق أن نطرحه على أنفسنا ليس ”ماذا يقدّم لي الذكاء الاصطناعي؟“، بل ”ماذا أقدّم أنا له دون أن أنتبه؟“.
